

过去谈视频参考,常常只问一句:能不能上传图片?Seedance 2.0 的发布说明把这个问题变得更具体了。除了图像,它还把视频、音频和文字放进同一次创作任务,让不同材料提供不同的信息。
本文内容(5节)
Seed团队在2026年2月12日公布的资料中,列出了多模态参考、15秒多镜头音视频、视频修改与延长等能力。这些内容共同指向一个变化:输入不只是告诉模型画面看起来怎样,也开始参与表达动作、镜头和声音。
其中最值得细读的,是官方对参考用途的说明。相同的一段视频,可以用来借鉴动作,也可以用来借鉴镜头运动。这两种意图看起来都叫参考视频,最终希望保留的东西却完全不同。如果不说明,素材里的背景、人物和运动就可能一并成为影响因素。
这解释了为什么上传更多材料,并不一定让任务更简单。一个场景已经在图片里确定,另一段动作参考却发生在不同空间;一段音频有明显的停顿,文字描述又要求动作连续完成。输入各自都合理,放在一起却可能指向不同结果。
制作前为素材分配用途,因而不只是管理习惯,而是在说明创作意图。人物资料回答是谁,环境资料回答在哪里,动作片段回答怎样运动。哪些内容要借用、哪些内容只用于理解背景,也需要一起讲清。
还有一个容易混淆的地方:人物参考图不等于剧情首帧。参考可以提供身份或外观,首帧则规定视频一开始的画面状态。直接把一张人物组合板放进首帧入口,模型面对的任务,与从中提取角色再放入场景并不一样。文章和教程都应该按实际入口来写。
给每份参考分配一项工作
假设要拍一段年轻厨师端菜走过餐厅的镜头。人物板提供厨师的外观,餐厅图提供空间,动作参考说明托盘怎样保持平衡,音频提供某句对白。上传之前,可以把这四项分别写出来,而不是只说“结合所有素材生成”。
如果参考片里的人物穿黑色制服,你的原创角色穿白色厨师服,就要明确借用动作而非服装。若餐厅参考是一张空景,也要说明角色放在哪里、从哪里往哪里走。素材数量增加以后,分工越清楚,后续判断越容易。
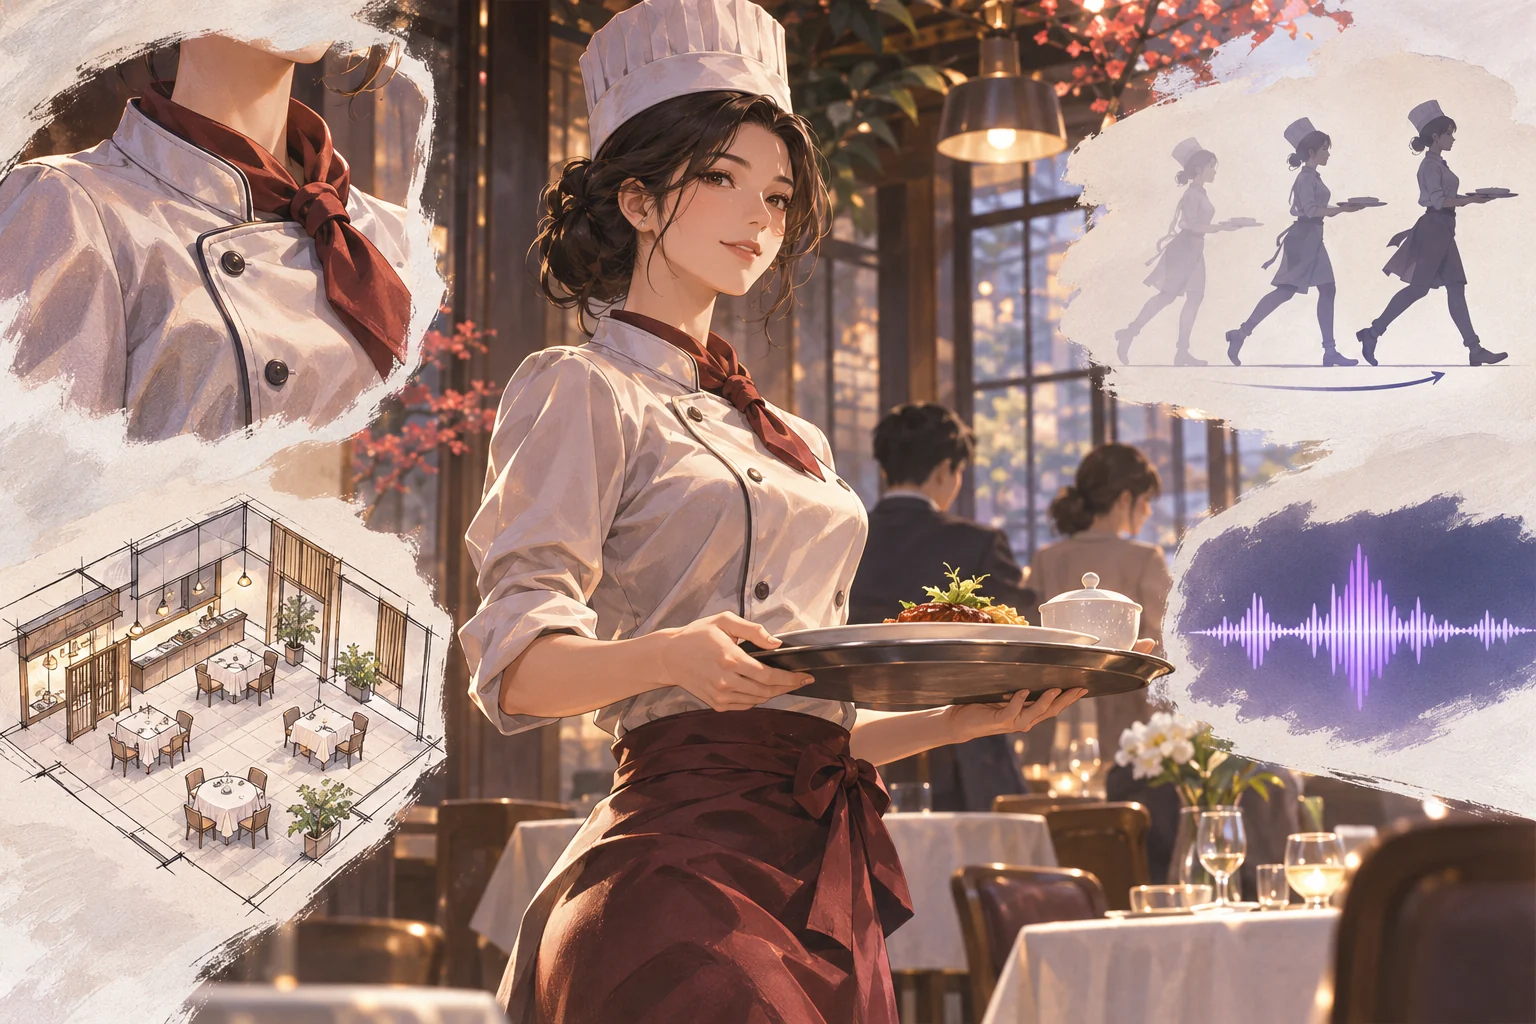
参考多了,提示词首先要做的是分配职责
Seedance 2.0发布介绍提到文字、图片、音频与视频共同输入,并列出了对应素材数量。对创作者来说,最直接的变化是可以不只靠一张图解释任务。但参考之间的作用仍需明确:人物资料解决外观,动作视频说明运动,音频可能提供声音或节奏,场景图说明环境。
以厨师端出一道菜为例,可以指定图片A提供厨师外观,图片B提供餐厅空间,视频C只借用从后厨走向餐桌的动作方向。若C里的演员穿不同服装、端着另一种器皿,就应明确哪些内容不沿用,避免参考中的附带信息压过本来目标。
这里不需要把每份素材都写成长说明。每份一句用途,整场戏再写一句目标,已经比“参考以上素材,制作电影感视频”清楚。后者把决定全部交给系统,也让失败后难以知道究竟是哪项输入发生冲突。
冲突通常藏在看似合理的资料之间
人物板是正面站姿,动作参考却要求一直背对镜头;声音需要慢慢说完一句话,镜头安排却让人物马上离开画面;场景通道狭窄,参考动作又有大幅转身。每一份都不算坏材料,放进同一任务却可能互相牵扯。
可以先决定哪个要求最重要。若剧情必须看清表情,就调整机位和动作;若重点是穿过空间,就给路径留够画面。不要把所有要求都标成“必须保持”,再把矛盾交给模型自行解决。
先让一条简单的上菜镜头成立
可以从厨师已经站在桌旁开始,只完成放盘和退开。先确认盘子落在桌面、双手适时松开、人物退开方向有空间。这个小任务通过后,再增加走路、客人反应或镜头移动。不要第一轮同时要求长距离跟拍、复杂对白和快速转场。
若使用首帧路径,起点应把厨师、餐桌与盘子安排到合理关系里。若使用参考路径,则按所选模式说明提供资料,并用文字安排场景与动作。两种方式都能用图片,但不能把分栏角色板当成已经完成的剧情画面。
一个常见问题是目标动作与图片状态冲突:盘子已经放在桌上,提示词却要求“从手中放下”;门已经打开,文字却要求“先开门”。输入越丰富,越需要先排除这些矛盾。很多不自然的运动,最初就埋在材料之间。
参考、首帧和延长,要分别准备
人物组合板适合表达身份,不适合直接当所有剧情镜头的第一帧。需要明确起点时,先把人物放进餐厅,确定托盘、手和身体之间的关系,再交给关键帧入口。需要延长已有视频时,则应检查原片结尾的状态,后续动作要能够从这里继续。
如果把参考模式的教程复制到首帧模式,读者可能上传同样文件,却获得完全不同的结果。文章和素材包最好写清每张图的用途,特别是含多个角度的人物板,避免它在视频开头变成并排的几个角色。
原生声音让表演安排更早开始
如果这一镜需要厨师说“请慢用”,应想清楚他说话时是否仍在放盘,客人是否需要回答,动作声是否会压住台词。生成声音不是给画面随意加一条配音,而是把声音纳入同一段时间。
可以先写一版最短对白,留出动作开始与结束的余地。若一句话需要很长时间,考虑把说话放到另一条镜头或画外,而不是让人物边完成多个动作边快速念完。节奏安排清楚,后续才容易判断口型、语气与画面是否匹配。
采用结果时保留整条原片,并记录剪辑使用的区间。下一镜若需要延续同一状态,从当前真实结尾出发准备,而不是再次从最早的参考资料独立推导。原生音画与多参考提供更多输入可能,连续制作仍需要维护已经发生的事实。
对想开始使用的人,最实用的第一步不是搜集更多素材,而是把手头资料整理成一个没有冲突的小任务。完成后再增加复杂度,才能知道模型升级究竟减少了哪一类返工。
来源:Seedance 2.0官方发布介绍。厨师上菜流程为本站自拟示例。
让试验结果能反过来改善素材
第一次尝试失败以后,先分类:人物变了、动作不清、机位不对,还是声音节奏不合。针对问题调整一项,再保存输入版本。若只是继续增加材料,最后很难知道哪份参考真正起作用,也很难把成功结果复用于下一个镜头。
多模态的价值不在于把文件塞满,而在于用合适的材料表达文字难以说清的部分。人物、空间、动作和声音各有职责,把它们组织成同一个意图,才是这类能力进入连续制作的关键。
这次发布的意义,在于把创作意图分散到更多种输入中。它给了创作者更丰富的表达方式,也让素材之间是否一致变得更重要。官方演示可以帮助理解这些入口,至于角色能否跨段保持、多人动作是否可靠,仍不能只凭素材数量得出结论。
多模态输入可以先做一次“矛盾检查”
把每份资料的用途放在一行,再横向看:人物图中的厨师是长袖,动作视频中的人是短袖;场景图桌子很高,目标动作却要求坐着把盘放下;音频是一句从容介绍,视频动作却非常急促。这些冲突不需要等模型生成后才发现。
需要借动作而不借服装时,就把作用说清;场景不支持动作时,先改机位或空间;声音节奏不合时,先调整台词与时长。输入更丰富以后,创作者也更有责任说明采用哪些部分。
删去无关资料不意味着降低专业程度。一个清楚的任务包比一个塞满所有参考的任务更容易理解,也更方便后续只替换其中一项。
完成后把输入用途与结果对照。若某份参考没有带来需要的信息,下次可以不再沿用;若它明显影响了不该改变的部分,则需要重新安排职责。
资料来源与延伸阅读
资料复核:2026年11月4日。文中的自拟情节、演算与检查方法用于教学;产品能力以对应版本的公开说明为依据,未将文档核对写成账号实测。