

一段视频里多了几个镜头,不一定就多了一个故事。观众需要知道人物为什么来到这里,动作怎样接上,声音又属于谁。
本文内容(5节)
快手在2026年2月5日介绍可灵3.0系列时,将多镜头叙事、原生音频和参考控制放在重要位置。Video 3.0 Omni还谈到故事板中的镜头时长、景别、视角与运镜安排。
这些控制项接近制作中的真实决定。远景用来交代关系,近景让人注意到表情;一个镜头结束得早一点,可能留下悬念,晚一点又会把反应交代完整。模型能接收这些安排,才让多镜头不只是自动切几次画面。
但输入更接近导演工作,也意味着导演意图需要说得更清楚。如果前后人物位置互相矛盾,或者说话顺序没有安排,多一个控制入口并不能自动生成合理决定。
参考素材也需要放到这种关系里理解。角色图帮助延续身份,场景资料帮助确定空间,镜头节点则安排观众何时看到什么。它们可以互相配合,却不宜因为文件格式相同就被当成同一种输入。
这次公告涉及多个型号。不同型号的故事板、音频与参考功能需要分别核对,不能拿整个系列的介绍,拼出一个任意入口都具备的功能组合。
先给每个镜头一个明确任务
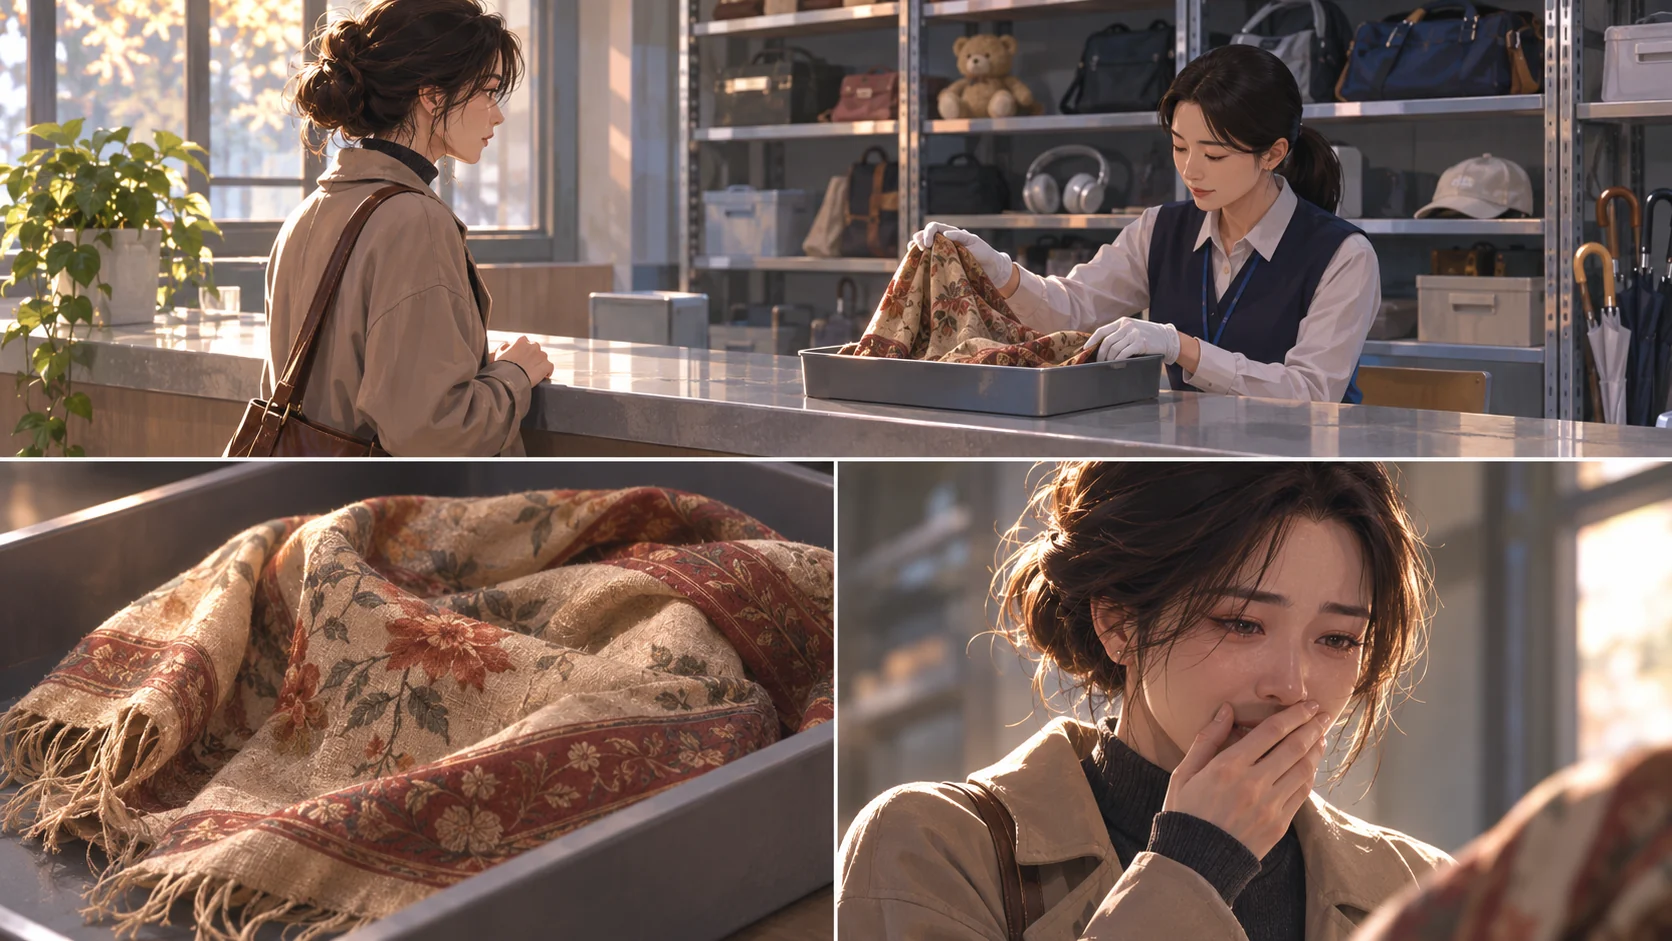
例如失物招领处的一场戏,可以先用中景交代工作人员与来访者的关系,再给被认出的旧围巾一个细节,最后看人物反应。三个镜头各自提供新信息,才构成推进。若只是同一人物从远景切到近景再切回远景,多了切换,也未必多了故事。
分镜表可以写清景别、主体、动作、声音与结束状态。结束状态尤其重要:围巾还在工作人员手上,还是已经递给来访者?后一个镜头需要从哪里接?这些决定如果没有明确,连续生成也可能在细节上自相矛盾。
先决定观众必须看到哪三件事
可灵3.0的官方介绍同时强调多镜头叙事与原生音频。对短剧来说,多镜头的价值不在于一段里切换了多少景别,而在于不同画面能否共同讲清一件事。比如失物招领场景,观众需要看到物件、认出它的人,以及人物因此作出的决定。
可以把一场戏写成三句:柜员取出围巾;来访者认出围巾上的修补线;她原本准备说的话停住。第一镜交代双方与柜台,第二镜让修补线可见,第三镜留给反应。三镜承担不同信息,而不是同一句台词换三个角度。
若把三镜分别生成,也应沿用相同围巾、柜台与人物服装。若一次生成多镜头,则需要在指令里说明这些连续关系。多镜头能力减少一部分组织工作,不等于模型会自动知道哪条缝线对剧情最重要。
镜头之间,要保留观众能追踪的线索
人物左右位置、视线方向、道具归属和主要光向,是最常见的线索。双人中景里来访者在左,切近景时应能理解他在看谁;围巾从哪边递出,接物动作也要对应。把静态分镜先拼一遍,往往更容易发现这些问题。
连续性并不是要求每张图完全相同。人物可以移动,摄影机也可以换边,但变化应该被交代。一个重新建立位置的全景,或清楚展示移动过程的镜头,都可能帮助观众重新定位。偶然生成的左右翻转,则不能自动当成有意设计。
特写不是放大上一张图,而是改变信息重点
全景里围巾只需要让人知道它在柜员手里,特写中修补线才必须清楚。如果从第一镜就把花纹写得过分复杂,却没有说明哪一处是识别线索,后续可能得到很多精致细节,唯独缺少剧情需要的那一条。
人物反应也要有对象。近景眼神朝下,对应柜台上的物件;如果突然望向画面外另一边,观众可能以为她发现了新人物。切近景时保留视线、身体方向和适当的环境线索,能帮助观众把空间接回来。
必要时加入一个短停顿。柜员刚放下围巾,人物立刻哭起来,情绪可能显得没有经过认知过程。让目光先落到修补线,再出现反应,观众更容易跟上。这个变化属于表演与剪辑安排,不是单靠提高画质就能获得的。
原生音频让责任更早进入镜头
当声音与视频一起生成,说话顺序、角色声音和动作节奏就需要提前考虑。两个人同时出镜,不代表模型自然知道哪句属于谁;台词很长,也不一定能塞进预定镜头。先做一版临时对白,确认语气与停顿,再安排镜头,会更容易发现长度冲突。
结果验收时,既看画面,也听说话者是否清楚、对白是否被截断、背景声是否盖住信息。画面切到听者时声音可以继续,但观众应理解是谁在说。声音能够一起生成,不等于不再需要剪辑与混音判断。
多人物音频,先确认谁说、谁听
同一段里有柜员介绍、来访者回答与旁白时,先把说话顺序写清楚。每句话标明人物,避免只给一段带引号的连续文字。若需要画外旁白,也应与画内对白区分,否则嘴型与声音归属可能不符合预期。
生成后可以先不看字幕听一遍,判断能否分清人物;再静音看,观察轮到谁说话时谁在张口;最后把声音与画面合起来,检查停顿和反应。字幕能帮助理解文字,却不能修复说话者对错。
如果三镜中只有一镜存在问题,拆镜生成通常便于替换;如果整段动作与对白高度连贯,一次生成可能更容易保留整体节奏。选择时看修改粒度与交付需求,不必把所有项目都强行做成同一种方法。
多镜头更新最终把一部分镜头组织提前到了生成输入。你需要更清楚地知道这场戏在什么时候让观众看见什么。分镜越明确,越能利用这些控制;分镜本来含糊,更多景别也可能只是把含糊剪得更热闹。
来源:快手:可灵3.0发布说明。围巾识别场景为本站自拟分析。
选择多镜头生成,还是分开制作
如果一组关系简单、输入明确的镜头适合连在一起,可以尝试一次组织;若某个镜头需要大量局部修改,单独制作也可能更方便。应按返工方式、素材复用与剧情需求选择,而不是把单次输出长度当成必须填满的指标。
对创作者而言,这次变化增加了把分镜意图传进任务的机会。更应该认真准备的是每个镜头为何出现、前后怎样连接、哪里允许变化。模型能够接收更多控制时,创作决定也需要更具体。
我认为这项变化的意义,是让一部分原来依靠多次独立生成再拼接的决定,有机会更早进入任务本身。它没有让分镜失去作用;恰恰因为模型开始接收更多安排,分镜是否成立变得更重要。
把一场戏拆成“发现之前”和“发现之后”
来访者认出围巾之前,动作可以比较正常,注意力在办理手续;认出修补线以后,她的目光、说话速度与手部才出现变化。这个前后差别帮助观众理解情绪不是凭空发生。
如果三镜都要求同样强烈的悲伤,观众反而看不出那一次认出的意义。先建立普通状态,再让一个具体线索触发变化,往往比从第一帧就堆满表情更有层次。
分镜指令也可以按这一转折写:先展示柜员取物,再展示识别线索,最后呈现反应。对白可以停在反应之前,给观众一个自己读懂的机会。不是每个信息都需要旁白解释。
生成结果若把修补线变成另一种花纹,或人物在看见之前就哭泣,应该分别回到道具与时间安排。多镜头能力的价值,需要用这些具体叙事条件来衡量。
资料来源与延伸阅读
资料复核:2026年11月4日。文中的自拟情节、演算与检查方法用于教学;产品能力以对应版本的公开说明为依据,未将文档核对写成账号实测。