

白底人物设定图已经做好,接下来想拍“女孩在雨夜走进便利店”。把设定图上传,写上雨夜、玻璃门、推门进入,结果视频却从白底站姿开始,背景再慢慢变成街道。画面有了动作,故事的第一秒还是不对。
本文内容(8节)
这时先别继续堆提示词。要先看上传入口旁边写的是什么:人物参考、首帧,还是首尾帧。它们都能收图片,图片承担的工作却不同。
先想清楚,图片要替你决定什么
人物参考图主要用来交代身份和外观:这是谁,头发多长,穿什么衣服,有哪些辨认特征。工具如果支持独立的人物参考,可以让它在新场景里重新安排人物。但“支持参考”也不等于每一项外观都会锁住,侧脸、遮挡和换光线后仍需要检查。
首帧则是镜头的起点。你上传一张白底站姿,等于把这张站姿交给视频作为开头;你上传女孩站在便利店门外、雨水落在肩上的画面,才是在准备这场戏的第一瞬间。脸、背景、构图和动作起势,都已经参与了镜头设计。
把便利店这场戏准备对
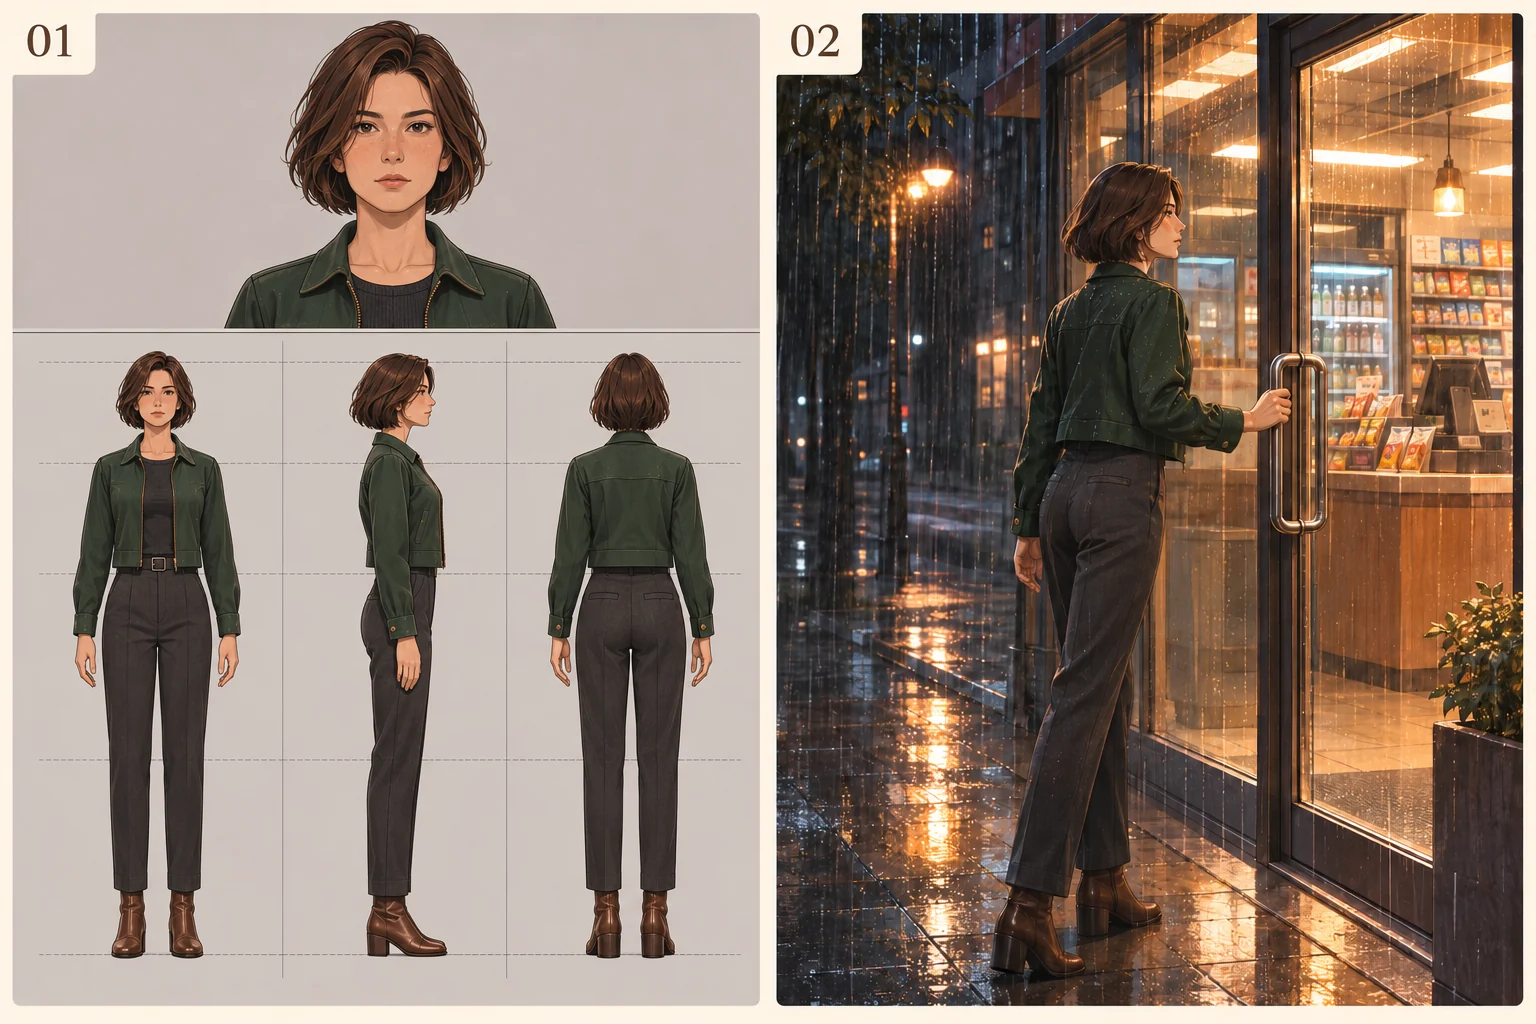
假设这一镜要表现“女孩推门,听到声音后停住”。可以先用人物参考板参与生成场景图:女孩侧身站在门外,手已经握住门把,玻璃门还没打开,门内留出能看见的空间。这张图确认后,再放进首帧入口。
视频提示词就可以集中写:女孩推开玻璃门,向前迈一步,听到店内声音后停下,视线转向柜台。镜头固定。若一段里同时要完成走近、抓握、推门、进门、转头,动作就太挤了,可以把走近门口另做一镜。
这里不是说手必须已经碰到门把。如果你要拍的正是“伸手去握”,起点当然可以在接触前。只是画面得看清手与把手之间的距离,动作路径也不能被身体或门框挡死。
三个入口,准备三种材料
- 文生视频:用文字交代人物、场景、构图和动作。没有上传图片,也不代表工具会自动记得上一镜的角色。
- 参考图生成视频:按该工具当前模式说明,指定人物、场景或其他参考素材的用途。参考板里的拼排不一定会成为视频开头,但也不能一概保证它不会影响构图。
- 关键帧图生成视频:先把故事起点画好。若模式接受首尾帧,尾帧还要考虑与起点之间能否连成合理动作,不能只选两张各自漂亮、关系不明的图。
入口名称会随产品变化。拿不准时,先用一个简单镜头确认:上传后,工具是把整张图当开头,还是把里面的人物带到新画面?这比直接生成一段复杂戏更容易看出自己有没有用错模式。
照着便利店这场戏,把三种模式各写一遍
文生视频主要靠文字建立画面,可以写:“雨夜,短发女子穿深绿外套站在便利店玻璃门外,侧身看向店内。她握住门把,推开门后停步,目光转向柜台。固定中景。”人物、环境与动作起点都需要在文字里交代,工具不会自动读到你本地的人物板。
参考图生成视频则先按入口提供角色与场景资料,再写它们的职责:“采用人物图中的外观与服装,采用店门参考中的玻璃门与灯光;安排女子在门外握住把手,随后推门并停下。”这里借用资料建立新镜头,参考板的白底和分栏不应被当作剧情目标,但实际如何引用仍需遵循模式规则。
关键帧图生成视频使用已经确认的剧情首帧。画面里女子已经站在门外、手与把手关系已成立,文字就集中写下一步:“她轻轻推开玻璃门,向前迈一步,听到柜台方向的声音后停下。镜头保持固定。”不再重复介绍整张板上每个角度。
实际准备一遍,文件就不容易放错
可以把这场便利店镜头的素材分成三份保存。第一份是人物标准板,文件名注明角色和当前服装;第二份是店门外的场景资料,用来交代玻璃门、柜台和光线;第三份才是已经结合人物与场景的剧情首帧。缩略图看起来差别很大,文件用途也能一眼识别。
若准备使用参考模式,按入口说明选择前两类资料,并明确它们分别提供身份和环境;若使用首帧模式,就选择第三份。文件夹里有什么,不代表工具自动知道什么,真正传入任务的内容才会参与生成。
上传前,用文件名和缩略图避免拿错
可以保留三份明确文件:角色组合板、便利店环境资料、镜头03剧情首帧。它们的命名直接写用途,比“图片1、图片2、最终版”更安全。组合板里有多个视角,环境图没有当前动作,剧情首帧只有故事中的这一刻,缩略图也应一眼能分辨。
如果工具需要裁切参考板,保留原板再导出所需局部,不要为了某次上传把唯一原图覆盖。裁出的脸部图用于身份,不等于下一镜必须采用相同肖像构图;裁出的侧面全身也不自动成为人物从侧面开始动作的首帧。
选好图片后,再看输入位的说明。产品可能把“参考”“素材”“帧”等词放得很近,不能只凭上传按钮长得一样判断。真正影响结果的是这个位置赋予图片的职责。
首帧需要到什么程度,取决于这场戏要看什么
如果只是交代人物进入店里,画面可以优先让门与身体关系清楚;如果重点是她握住门把却迟迟没有推开,手与把手就需要更近、更容易辨认。没有必要为所有镜头都做同样精细的手部特写,也不要因为脸画得最好就把门裁在画外。
先确定观众要读到的信息,再决定画幅和景别。一个漂亮正面肖像能很好地交代长相,却未必有足够空间容纳开门动作。首帧的标准不是“作为海报好不好看”,而是“能否把这个镜头合理启动”。
出现白底、人影或拼排时,回到输入职责排查
如果结果保留了参考板的白底,先确认是不是把它放进了起始帧槽;如果出现并排的多个人物,检查输入是否本来就是多视角拼排。遇到这些现象,继续写“只有一个人、不要白底”未必是最有效的第一步,因为入口可能正在忠实地延续你交给它的画面。
参考模式下也不能把所有异常都归结为入口错误。若工具确实接受人物参考,但衣服被改动,可以回头看参考清晰度、角色特征是否互相矛盾,以及提示词有没有重新描述另一套服装。先定位问题,再调整素材,才不会每次都把整个任务推倒重来。
结果出错时,按现象回到相应一层
视频先出现整张组合板,再变成街景,优先检查是否误用了首帧。人物身份不稳,但开头构图正确,检查参考质量与绑定方式。身份和环境都对,推门却没有发生,则回到动作起点、时长与文字要求。
如果门向不合理,先确认首帧中的门框与把手能否支持这个方向。要求向外拉,但门框显示向内开启,模型面对的是矛盾条件。此时修图或改变动作,比继续堆“物理正确”更具体。
遇到新工具,可以先用一个简单动作建立对入口的理解。确认它如何处理图片,再加入双人、对白与运镜。你需要掌握的是输入怎样转成结果,而不是背一条声称适用于所有产品的万能提示词。
相关模式资料:万相文生、首帧与多模态参考的任务区分、可灵参考与关键帧指南。三段提示词为本站自拟说明,不能当作不同产品通用的参数语法。
开始生成前,做一次“第一秒”口述
不看提示词,只看图片,说出这一刻已经发生了什么:人物站在哪里,手碰没碰到门把,门是开是关,接下来有哪条动作路径。再读视频提示词,看看第一件要求的动作能否从这张图自然开始。
如果两者对不上,就先修首帧或改动作起点。这个检查很简单,却能避免把“人长什么样”“故事从哪里开始”和“接下来怎么动”揉成一件事。配图中的人物板与店门画面是本站为说明区别生成的示意图,不代表某款视频工具的实际输出。
准备下一镜时,可以只问一句:“我要保留的是这个人,还是这张画面的第一秒?”答案不同,素材就应该不同。三种模式的完整安排见第六课:AI 视频制作。
不确定模式时,用一次简单试片回答问题
可以先只要求人物轻微转头,观察上传图片是否被直接保留为第一帧、是否出现整张板的拼排,以及是否真的借用了人物身份。把入口行为看清,再安排复杂剧情。
这次小样用于理解产品,不应被写成模型全面评测。它能帮你排除最基础的用错入口,却不能证明后续所有场景都会一致。
资料来源与延伸阅读
资料复核:2026年11月4日。文中的自拟情节、演算与检查方法用于教学;产品能力以对应版本的公开说明为依据,未将文档核对写成账号实测。