

一段参考视频,可以只借用里面的动作,也可以成为需要修改的对象。这两种操作看起来都在上传视频,创作目标却并不一样。
本文内容(4节)
MiniMax在2026年7月31日发布H3时,介绍了文本、图像、视频和音频上下文,并展示动作转移等用途。这类消息常常被浓缩成“支持多模态”,但真正影响使用的,是不同素材怎样参与任务。
借动作时,创作者可能只想保留身体运动,让人物与环境重新出现。改视频时,原片本身已经承载了镜头、节奏和空间关系,修改需要在这些内容上继续发生。若不讲清楚,模型可能借用了本来不想留下的东西。
这与声音参考也有关。一段声音可以提供语气或节奏,但不一定意味着作品需要复制原本的说话内容。输入越丰富,越需要说明每项资料的用途,不能指望模型自行决定所有保留范围。
因此,这次发布值得讨论的并不是素材清单有多长,而是创作者能否把意图拆得更清楚。是谁在表演,怎样运动,最终发生在哪里,哪些内容已经确定,最好不要全部塞进一句含混的描述里。
官方还谈到后续开放权重的计划。计划、实际下载、许可证和本地运行条件是不同阶段的事情,发布时的承诺不能替代后来发生的事实。历史文章也应保留这种区分。
同一段舞蹈,究竟要借哪一部分
假设你找到一段舞者从椅子上起身、绕椅转身的片段。如果目的是借动作,你想保留的是起身节奏、身体重心和转身顺序,未必想保留舞者的衣服与原来的舞台。如果目的是修改这段原片,则机位、节奏甚至场景都可能属于需要延续的部分。
因此,上传之前可以把保留项和替换项写成两句话:保留起身与转身的动作关系,人物换为自己的原创角色;保留原视频机位,不借用原舞台和服装。它不保证模型一定完全分开理解,却让你有依据判断结果究竟偏离了哪一项。
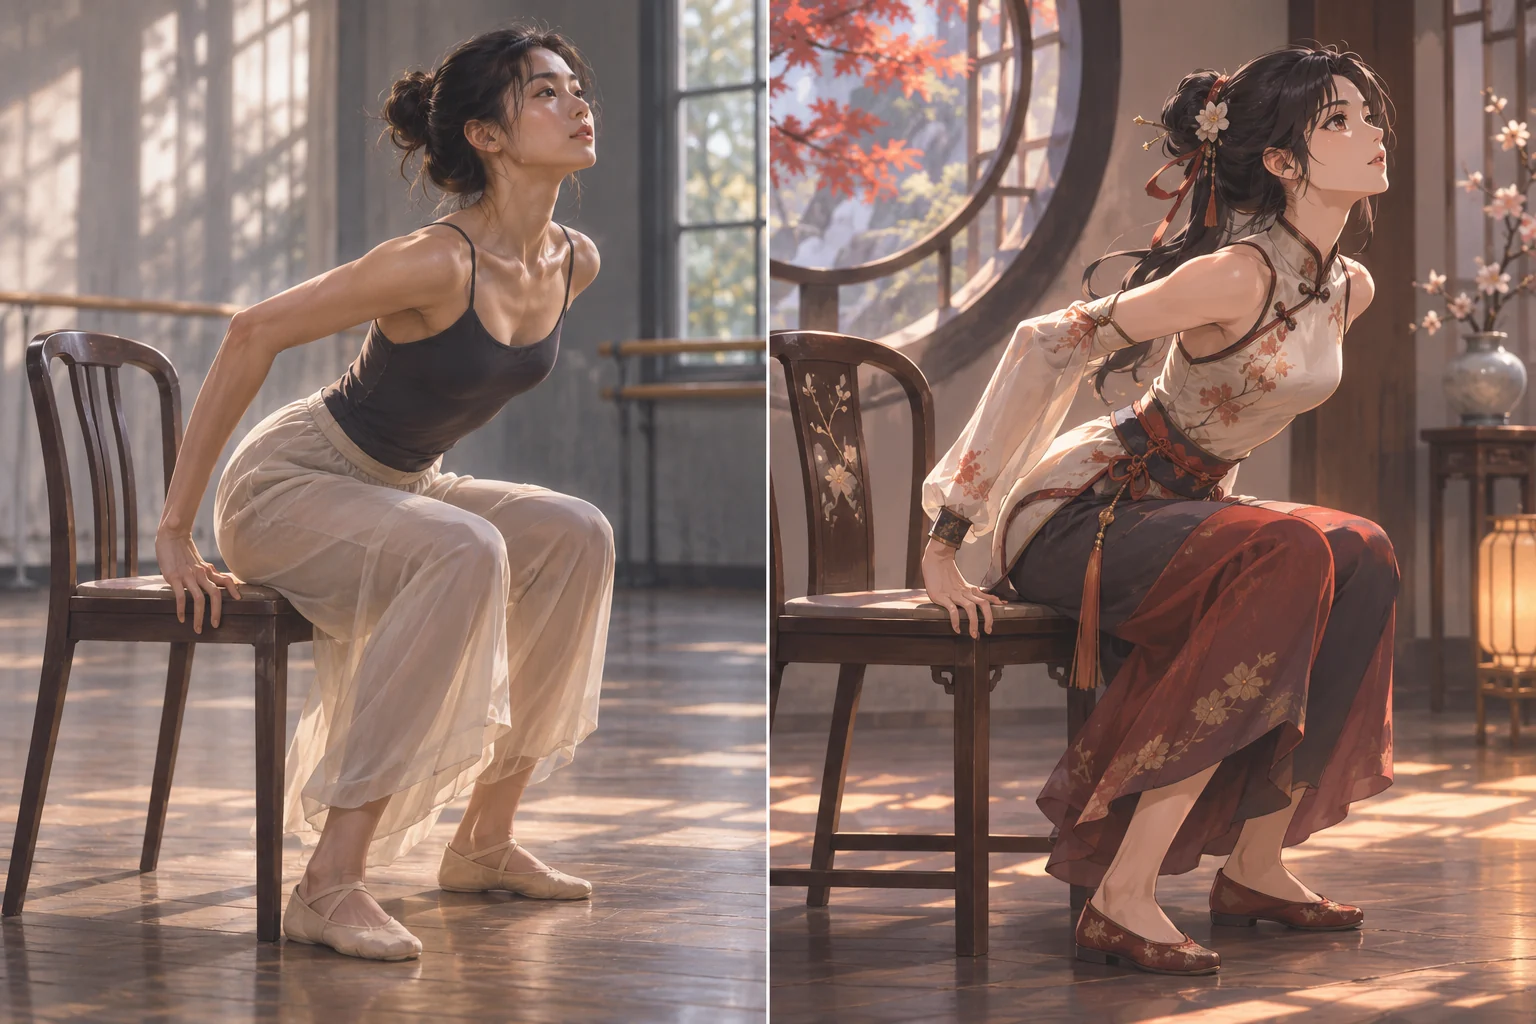
同一段视频,借动作和借镜头需要写出不同要求
MiniMax 在 H3 发布介绍中给过一个混合输入思路:从视频里参考运镜,让图片中的角色按音频歌唱。这里至少存在三项独立约束:摄影机怎样移动、出现谁,以及声音怎样对应表演。它不是简单地“把一段视频换个画风”,也不能把所有参考视频都理解成动作捕捉素材。
以一段舞者从椅子上起身、转身走开的录像为例。如果你要借身体动作,就需要关心支撑脚、重心转移和起身节奏;如果只借运镜,关注的可能是镜头从侧面绕到正面,角色完全可以做另一件事。这两种要求若只写成“参考视频1”,系统就得替你猜究竟保留什么。
更清楚的任务说明可以是:“角色外观采用图片A,只参考视频B里从坐姿起身的身体运动,保持固定镜头,不沿用B中的舞台背景。”若目标是借运镜,则把描述改成“仅参考B的缓慢环绕,人物保持站立”。这里是自拟的表达示例,具体输入槽与可组合类型需要按使用入口确认。
动作参考要先看得清动作
如果起身时手被桌子挡住,转身时脚离开画面,参考视频本身就没有清楚交代这些部位。后续生成可能补出动作,但补得是否符合你的要求,需要另外检查。参考素材越漂亮,不代表它越适合当前任务;有时一个机位稳定、全身清楚的简单片段更方便分析。
场景条件也会改变动作。一段在空旷舞台完成的转身,放进狭窄走廊时,人物可能与墙、椅子或门框发生冲突。借动作并不是把身体轨迹从环境中完全抽离,最后仍要看角色有没有足够活动空间。
如果只是想让人物带一点相同情绪,不一定需要把复杂动作全部搬过来。先找出真正有用的节奏:起身前的停顿,转身后的回望,还是手离开椅背的迟疑。把参考意图说小一点,常常更容易与具体剧情对上。
准备动作参考,先看它能不能被读清楚
不必一开始就找最炫的动作。对起身这类日常运动,身体关键部位可见、机位稳定、没有频繁遮挡的片段,通常更容易让你判断结果错在何处。手一直被桌面挡住的参考,不适合用来要求精确的扶桌动作;脚已裁出画外的参考,也无法直接说明落脚位置。
可以先剪出真正需要的动作段,删去前面等待和后面无关走动,再说明起点与终点。若一段里既有人入场、坐下、起身又转身离开,你实际上交给模型的是多个阶段。为一个两秒的起身镜头上传整段长素材,会让需求更含糊。
换成不同服装或身体比例后,动作也不一定能够照搬。长裙会遮住腿部,厚外套可能改变轮廓,手持道具又增加接触关系。你需要观察的是动作是否仍然成立:人物是否真正离开椅面、脚有没有滑动、起身后身体有没有突然变长,而不只是姿势轮廓是否像原片。
音频也要说明“听什么”,而不是只写“参考它”
一段声音里同时有台词、情绪、口音、音乐和环境声。你只想借说话停顿,却把整段混音作为参考,模型可能受到其他元素影响。准备材料时,先听出哪些内容是目标,哪些只是原片背景,并确认所用素材有合适的使用依据。
需要连续对白时,音色相似与表演合适也不能混为一谈。角色愤怒、克制或犹豫,依赖重音、呼吸和停顿,不只是“声音像”。生成后可以先不看画面听一遍,确认情绪走向,再判断身体动作是否与声音配合。
对于开源计划,实际采用前仍要逐项找到权重、代码、许可证与运行条件。能阅读一篇发布文章,不等于已经获得可本地运行的一整套工具。把“方向已经公布”和“自己现在能执行”分开,才不会用一个尚未验证的能力安排整部作品的交付时间。
H3呈现了一种更丰富的上下文输入方向。它能给模型更多信息,却不会自动消除信息之间的冲突。比“多模态更强”更有帮助的问题,是这些新增输入究竟让哪一种表达更容易说清楚。
声音参考加入以后,先安排谁在什么时候发声
H3 的发布说明将原生立体声和多模态上下文列为重点。对一场人物边起身边说话的戏,准备材料时仍要明确哪句台词由谁说、是否存在画外音、音乐是否需要压低。仅交一段背景音乐,再要求“有电影感”,不能代替对白与动作的安排。
可以先写出一版简短的声音顺序:“椅子轻响,人物站起后说完一句话,随后听到走廊脚步。”这样生成后容易逐项听:声音是不是来自画面里的动作,台词是否被音乐盖住,脚步有没有在人物还站着时提前响起。若准备后期独立配音,也应预留说话与反应的时间。
发布说明中关于开放权重的表述,还需要按时间阅读。原文说的是计划在之后开放,不能仅凭发布当天的措辞就断言已经能完整本地部署。对日常创作者,先弄清自己正在用哪个在线入口、支持哪些任务,比在未确认下载渠道前急着配置环境更实际。
这类模型的价值,最终落在参考之间能否形成一致要求。视频里动作向左,首帧却把人物紧贴左边缘,后续运动就缺少空间;声音要求持续歌唱,画面又安排人物背向镜头离场,也会影响你对口型的预期。整理输入时把这些矛盾先消掉,通常比追加更多风格形容词更有帮助。
来源与能力范围:MiniMax H3官方发布说明。文中的舞者与声音安排为本站提出的制作示例。
动作迁移最值得比较的,是变化发生的那一刻
坐着和站着两张静帧都正确,起身中间仍可能不自然。重点看臀部离开椅面、重心移到脚上、手不再支撑的几个时点。这些位置决定运动是否成立,也能帮助你判断参考是否拍得足够清楚。
如果结果只在服装样式上好看,动作却比原片含糊,先不要扩大到整场戏。可以保留同一参考,减少风格变化幅度,或换一个更简单的起身片段比较。让任务有可定位的问题,比一遍遍评价“质感不够”更有用。
资料来源与延伸阅读
资料复核:2026年11月4日。文中的自拟情节、演算与检查方法用于教学;产品能力以对应版本的公开说明为依据,未将文档核对写成账号实测。