

同样是往模型里放图片,一张图可能是在告诉它人物长什么样,另一张图却是在规定十秒之后画面必须变成什么样。二者在界面上都像上传素材,制作时却属于两种不同的决定。
本文内容(4节)
快手关于可灵4.0的公告,将多参考资产和多关键帧分别介绍。前者扩展可借用的人物、环境和动作信息,后者为视频里的视觉节点提供控制。这条消息真正值得解释的,是这两类输入为什么需要同时存在。
参考素材通常不会独自回答什么时候发生什么。角色图能够给出服装与脸型,却没有安排角色何时进入画面。关键帧能够规定某一刻的构图,也不天然包含这个人物在其他角度下的全部外观信息。把参考理解成身份与视觉资料,把关键帧理解成时间节点,就容易看出它们的分工。
这对连续制作尤其重要。几张都很好看的图片,如果机位、光线和空间关系各不相同,放在同一条时间线上,模型还得处理这些额外变化。增加节点以前,先让相邻画面属于同一个场景,往往比单纯增加图片更重要。
公告中的输入数量也需要按类别阅读。参考资产总量不等于首帧数量,更不能换算成模型保证完成的镜头数。一个节点的控制能力,与多个节点之间过渡得是否自然,是不同层面的结果。
从制作角度看,更细的输入允许创作者把一部分选择提前做出来。原来生成以后才发现的站位问题,可以在节点图里先处理;原来一句话很难说清的状态,可以直接画出来。但这种提前准备也有成本,需要有人判断画面能否连起来。
把“要用哪些素材”和“什么时候出现”分开写
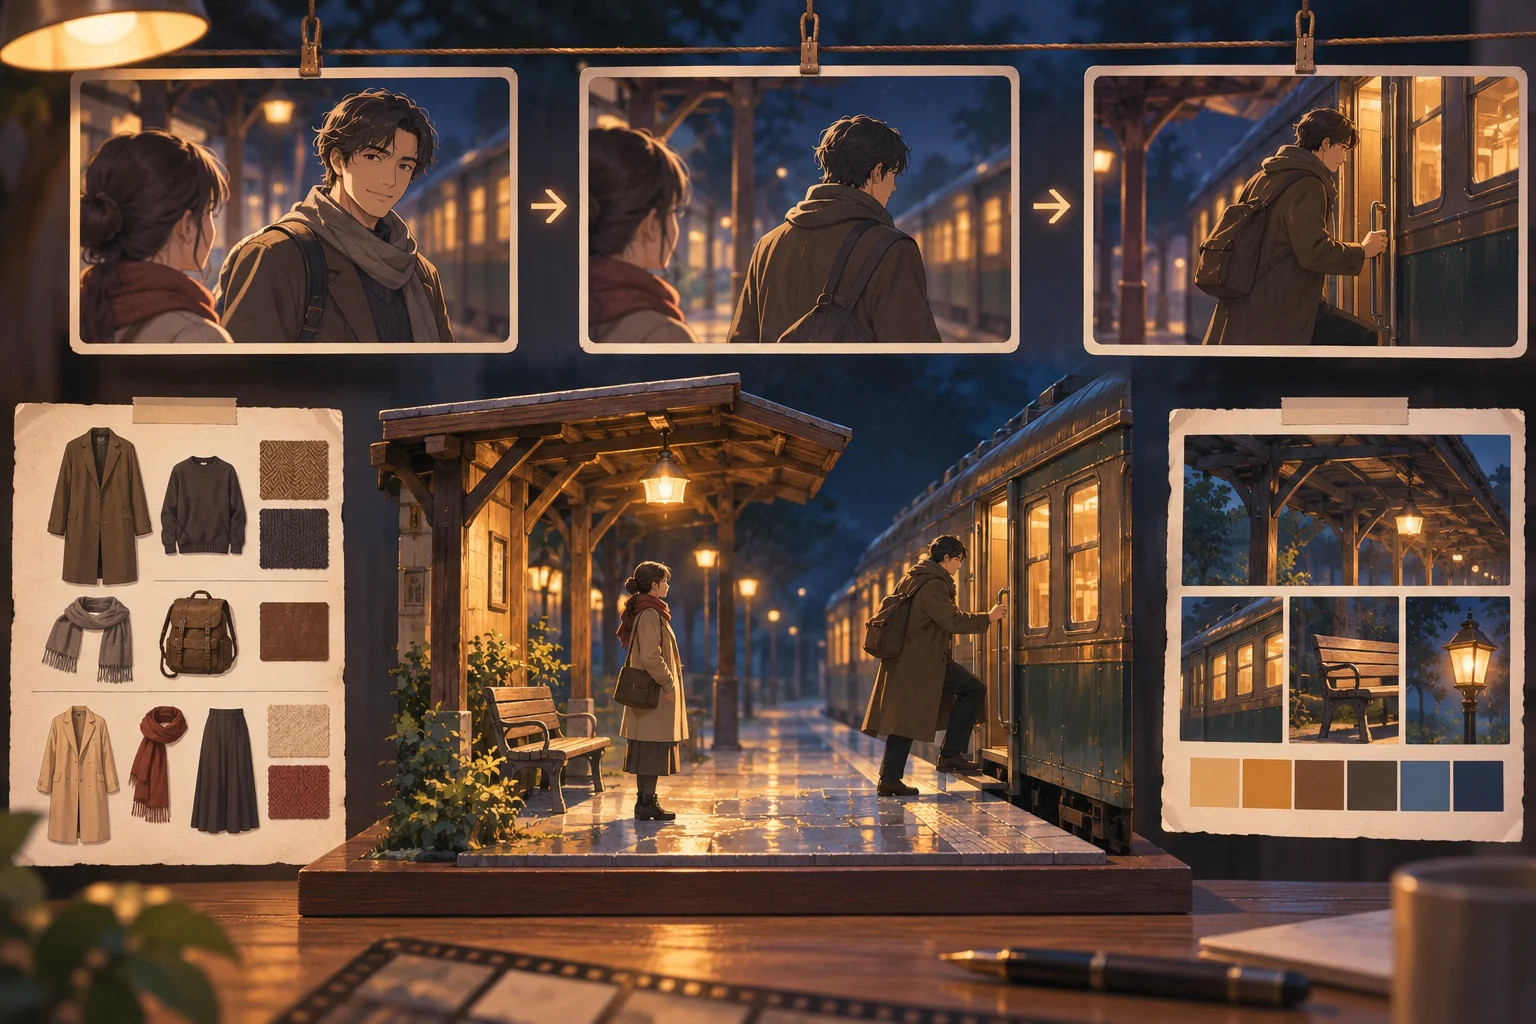
可以拿一场车站告别来理解。角色参考板告诉模型,这位乘客的发型、外套和旅行包是什么样;站台参考说明环境的材质与空间;关键帧则决定开头两人相对而立,随后有人转身,结尾车门关闭。三种材料都与同一场戏有关,但没有一种能包办其他两种。
如果只有角色参考,模型仍需要决定人物在哪里站、朝哪个方向走;如果只有几个关键帧,它还需要在中间维持角色外观。先给每份素材写一句用途,能帮助你发现缺项,也能发现冲突。比如站台参考是白天,尾帧却是夜景,这就不只是“人物不一致”的问题。
多参考和多关键帧,在官方指南里怎样区分
10月26日发布的可灵4.0使用指南,比发布新闻更适合回答输入怎么安排。指南将全能参考与多关键帧分别列出:全能参考允许图片、视频、元素等资料共同参与;多关键帧则用于确定视频时间线上的视觉状态。指南列出的参考任务总量上限为15项,多关键帧最多10张。各类素材另有分项限制,不能把几个分项最大值相加,当作一次任务能同时接收的数量。
更值得留意的是,指南对部分专业输出写了“即将推出”。文章读到4K、10-bit HDR等词时,要看它属于当前界面已经开放,还是公布的后续安排。介绍能力时把这两种状态写在一起,读者就可能为了一个还没出现在账号里的选项反复找菜单。
这里有一个很实用的判断:如果你关心的是“人物一直穿这件衣服”,先整理角色与服装参考;如果关心的是“结尾他已经离开站台”,先设计结尾状态。两者都需要时,再决定怎样组合。先辨认约束的类型,会比先把上传位填满更省事。
关键帧不是越密越好
关键帧最有价值的地方,是固定真正不能含糊的状态。人物是否已经上车、包还在谁手上、车门有没有关闭,都会改变故事。反过来,每隔很短时间都放一张只差一点的画面,可能增加准备量,却没有增加新的叙事信息。
先把相邻两张图放在一起看:身体的朝向能否过渡,人物脚下有没有移动空间,道具有没有突然换手,镜头是不是无意间跳到轴线另一侧。若两张图本身相互矛盾,增加中间节点未必能解决,可能只是把问题分散到更多位置。
也要允许画面之间存在需要表演的时间。一个人从犹豫到转身,不只是两张姿势的数学插值。目光停留、手部放松和迈步起势,都可能影响情绪。节点负责明确边界,具体过渡好不好,仍要连续播放结果才能判断。
以车站告别为例,怎样准备一份不打架的素材包
先用一句话定故事:妹妹赶上列车,姐姐留在站台,临走前把旅行包递回去。把“赶上车”和“包归谁”写清楚,这场戏的材料就有了筛选依据。角色参考只保留当天穿着,环境参考选同一侧站台;不把另一套服装、相反行驶方向的列车一起塞进去。
然后列三个状态。开头,两人在车门外,包在姐姐手里;中间,妹妹接住包,人还没有完全跨进门;结尾,妹妹已经站在车内,姐姐留在外面。三个状态需要沿用相同的车门、人物关系和包。若中间一张把包提前放到行李架上,模型不仅要生成递包,还得解释一个画面外的放置动作。
接下来决定镜头。可以把递包做成一条中景,把车内回望另做一条近景。不要因为一次能生成更长,就把全景交代、递包、上车、关门、挥手和列车离站都塞进同一个连续机位。多关键帧提供了安排节点的空间,导演仍需要决定哪些动作值得在同一条里完成。
对于必须完成的状态,用画面固定;对于节奏,用文字说明。例如“接包前停顿,确认对方已经握稳后才松手”,比只写“依依不舍,电影感”更接近可执行的表演要求。若参考视频只用来借鉴缓慢推进,也应明确说明参考运镜,不要连原视频的人物动作一起借入。
更适合怎样开始试用
可以先做单人、单场景、一次明确动作的镜头。例如乘客将车票放进外套口袋,开头和结尾都有清楚状态。先让人物、衣服与动作连接通过,再逐步加入第二个人或复杂运镜。不要第一次就把十几个参考全部交进去,失败后却不知道是哪份材料产生了影响。
参考素材多时,文件名和版本尤其重要。同一角色有日常服和工作服,要明确本镜采用哪一套;已经淘汰的脸部设定不要混入候选。多输入能力增加了表达空间,也增加了误用旧资料的机会,整理素材本身就是制作工作。
最终比较新流程值不值得采用,可以看几个实际结果:需要改站位时能否保留外观,改变一个节点会不会牵连整段,找到可用版本用了多少轮。这些记录比只挑一条最佳演示更能说明工作量。本文给出的是建议的验证办法,并不是本站已经完成的型号测试结论。
我更愿意把可灵4.0的这项变化看作制作责任的重新分配。模型接收更多明确条件,创作者负责把这些条件组织成一个成立的镜头。它不是把分镜工作省掉,而是让已经做好的分镜有更多机会进入生成过程。
生成后先验收交接,再评价表情
这类镜头很容易出现“看起来完整,事情却没完成”的结果。先遮住声音,检查旅行包是否真的从一人转到另一人手里;再看妹妹进门后的位置是否合理。包在两个镜头里换了背带长度、人物进门前后反向,都会影响后续剪辑,不应被漂亮的脸部细节掩盖。
如果只错了一处节点,可以先改对应图片或对应表述,再沿用其他输入。若所有状态都对但节奏太赶,才处理时长与动作安排。这样每轮只解决一个主要问题,比较时能看出多关键帧究竟帮助了哪一项。
选择整段生成还是拆镜,还可以看修改发生在哪里:如果每次都只需修中间一小段,而前后已确认,就优先寻找能局部修改的路径;如果人物与空间每轮都大幅漂移,先减小任务复杂度。工具提供的最大时长是能力边界,不是每场戏都必须用满的目标。
把一份素材包交给别人,看看他能否读出同一场戏
不解释背景,只交角色参考、站台资料和三个节点,让另一位制作人员复述人物移动与旅行包去向。如果对方理解成姐姐上车、妹妹留在外面,说明素材职责或状态还不够明确。这个问题应该在生成前处理。
可以在每张节点图旁只写“此刻已经发生”和“接下来发生”两句。开头包在姐姐手里,接下来交给妹妹;中间妹妹已接住,接下来进入车内;结尾妹妹在车内,姐姐在外面。简短状态比重复一长串风格描述更方便协作。
资料来源与延伸阅读
- 快手科技:Kling AI Officially Launches Next-Generation Kling 4.0, Raising the Bar for Professional-Grade Video Models
- 可灵4.0官方使用指南,2026年10月26日
资料复核:2026年11月4日。文中的自拟情节、演算与检查方法用于教学;产品能力以对应版本的公开说明为依据,未将文档核对写成账号实测。